
AI 是如何变强的?Jeff Dean 斯坦福分享解读
转述 Google AI 负责人 Jeff Dean 在斯坦福的分享:从神经网络构想、TPU、Transformer 到强化学习,梳理 AI 过去 15 年变强的关键节点。
最近一周,AI 圈的信息密度有点太大了。
先是 Google 发布了 Gemini 3.0 Pro,紧接着又甩出了能让图片思考的 Nano Banana Pro,随后 Anthropic 的 Claude Opus 4.5 紧追不舍。
不知道你有没有这样的感受,就是每一次新产品的发布,感觉又是一次全新的蜕变,AI 的进化速度怎么就这么快?
正好,今天看到了 Google AI 负责人 Jeff Dean 在斯坦福大学的一个分享视频。
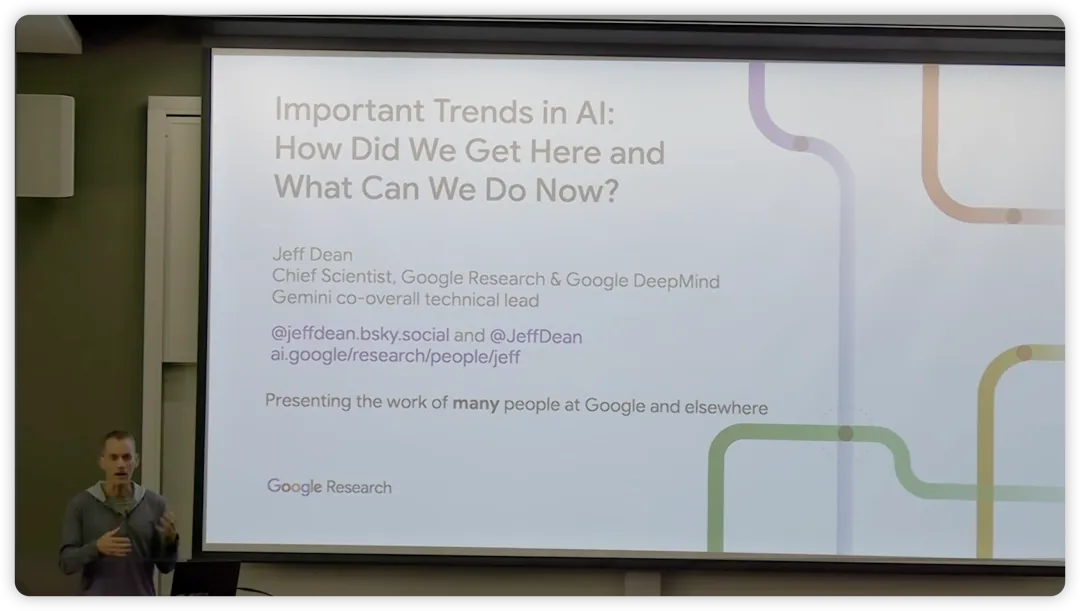
他用四十一分钟,清晰地梳理了 AI 在过去 15 年里,一步步走到今天的关键节点。
看完之后,受益匪浅。
所以这篇文章,我想把核心观点转述出来,与你一起回顾这段精彩的进化史。
我们今天所说的 AI,其核心技术之一「神经网络」,并不是新鲜事物。
它是一个诞生于几十年前的构想,核心是模仿人脑神经元的工作方式,让机器从数据中自己学习。
这个构想很理想,但长久以来,一直没能真正落地。
早在 1990 年,Jeff Dean 还在读大学时,就对这个想法深深着迷。
于是,他信心满满地写了篇毕业论文,计划用系里最先进的 32 核处理器,去训练一个强大的神经网络。
结果呢?
他后来自己笑着承认,当时的想法「完全错了」。
因为他很快发现,要想让神经网络真正产生智能,需要的不是 32 倍的算力,而是 100 万倍。
这就像人类很早就有了飞行的梦想,也画出了翅膀的草图。
但直到内燃机的功率达到某个临界点,飞机才得以挣脱地心引力。
AI 的发展,也一直在等待它的「发动机」。
真正的转折点,发生在 2012 年。
有一天,Jeff Dean 在 Google 的茶水间,偶遇了当时还在斯坦福任教的吴恩达(Andrew Ng)。
两人一拍即合,都觉得时机成熟了。
吴恩达说他的学生用神经网络在语音问题上取得了不错的成果,Jeff Dean 则兴奋地回应:「那我们应该训练一个真正巨大的神经网络。」
这就是 Google Brain 项目的起源。
他们目标只有一个:用用 Google 海量的计算资源,去训练一个比全世界任何人都大 50 到 100 倍的神经网络。
虽然这个规模在今天看来不值一提,但在当时,这无异于在自行车时代造出了一台蒸汽机。
在这之前,教机器认识东西,得用一种叫「监督学习」的方法。
什么意思呢?
就是你得先找几万张猫的照片,一张一张地给它们打上「这是猫」的标签,然后喂给机器,让它学习。
这个过程,费时费力。
有了这个模型后,他们干了一件颠覆性的事:直接从 YouTube 上随机抓取了 1000 万张视频截图,把这些图片喂给这个巨大的神经网络。
整个过程没有任何人工干预,没有标记「这张是猫」或「那张是人」。
结果,神奇的现象发生了。
训练结束后,网络中有一个神经元,对「猫」的图片表现出极强的激活反应。
在无人教导的情况下,从海量、杂乱的数据中,自己归纳并形成了「猫」这个抽象概念。
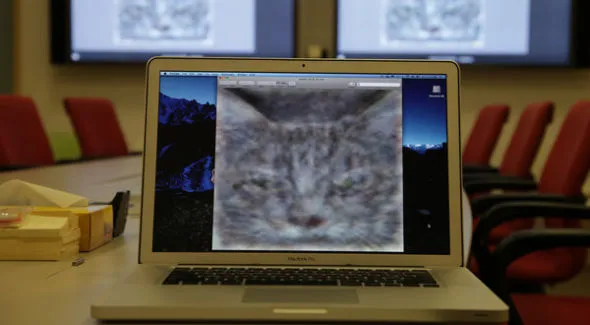
这在当时是颠覆性的。
因为在此之前,要让机器认识猫,需要先给几万张图片打上「这是猫」的标签。
而这项研究证明了,只要算力够大、数据够多,「无监督学习」是可行的。
这次实验,直接让当时一项图像识别基准测试的准确率,相对提升了整整 70%。
这是 AI 进化史上的一大步,第一次展现出了脱离人类标签、自主学习的潜力。
在图像识别上取得突破后,下一个更难的挑战是,如何让机器「读懂」人类的语言?
这背后,同样有几个关键的技术突破。
第一个叫「词向量」(Word Embeddings)。
在过去,机器眼中,文字只是一个个独立的符号。
它无法理解「猫」和「老虎」之间有什么内在联系。
但人类知道,它们都属于「猫科动物」。
词向量技术,则是把每个词语,都变成了一个高维空间里的坐标。
当模型学习了海量文本后,神奇的事情发生了:在那个高维空间里,意思相近的词,它们的坐标也靠得很近。
更神奇的是,这些坐标之间的「方向」竟然也有意义。
最经典的例子就是那个著名的公式:国王 - 男性 + 女性 ≈ 女王。
也就是从「国王」的坐标走向「王后」的坐标,这个方向和距离,与从「男人」走向「女人」几乎完全一致。
这意味着,AI 开始理解词语与词语之间的复杂关系了。
第二个突破是「序列到序列模型」(Sequence to Sequence)。
这个模型让机器翻译的质量产生了飞跃。
它能先把一个完整的句子(一种序列)读进去,在内部形成一个综合的理解,然后再生成另一个意思相同但语言不同的句子(另一种序列)。
有了这两项技术,AI 才算真正开始踏入人类的语言世界。
随着模型越来越强,新的瓶颈又出现了——还是算力。
Jeff Dean 讲了一个亲身经历。
2015 年,他们团队开发出了一个效果极好的语音识别新模型。
但如果要把它推广给所有用户,经过计算,谷歌需要将当时全球数据中心的计算机数量,直接翻一倍。
这个成本,显然是无法接受的。
怎么办?
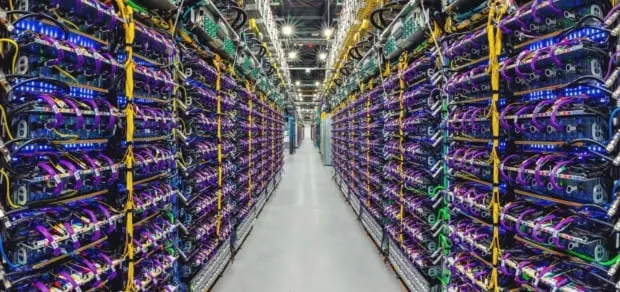
既然通用的 CPU 跑不动,那就为 AI 计算构建专用硬件。
于是,TPU(Tensor Processing Unit,张量处理单元)诞生了。
相比于什么都干的 CPU,TPU 砍掉了很多通用功能,把所有资源都放在在 AI 最需要的矩阵运算上。
结果是惊人的。
第一代 TPU,就比同时代的 CPU 和 GPU 快 15 到 30 倍,能效(也就是每度电能完成的计算量)更是高出 30 到 80 倍。
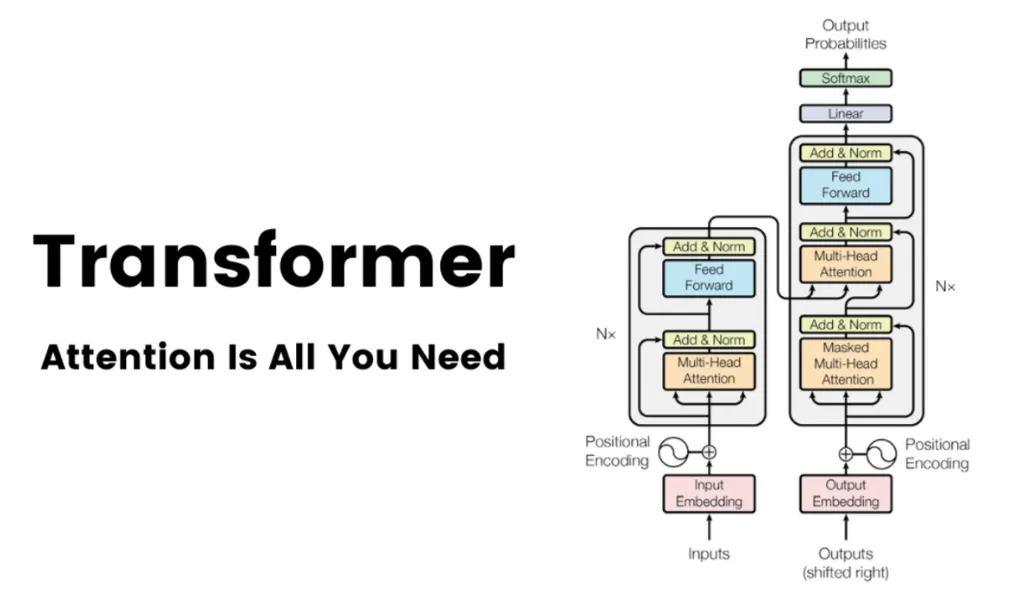
如果说前面的技术都是在为 AI 的进化添砖加瓦,那么 2017 年「Transformer」架构的出现,则是一次变革。
它的核心,源于那篇经典的论文《Attention is All You Need》。
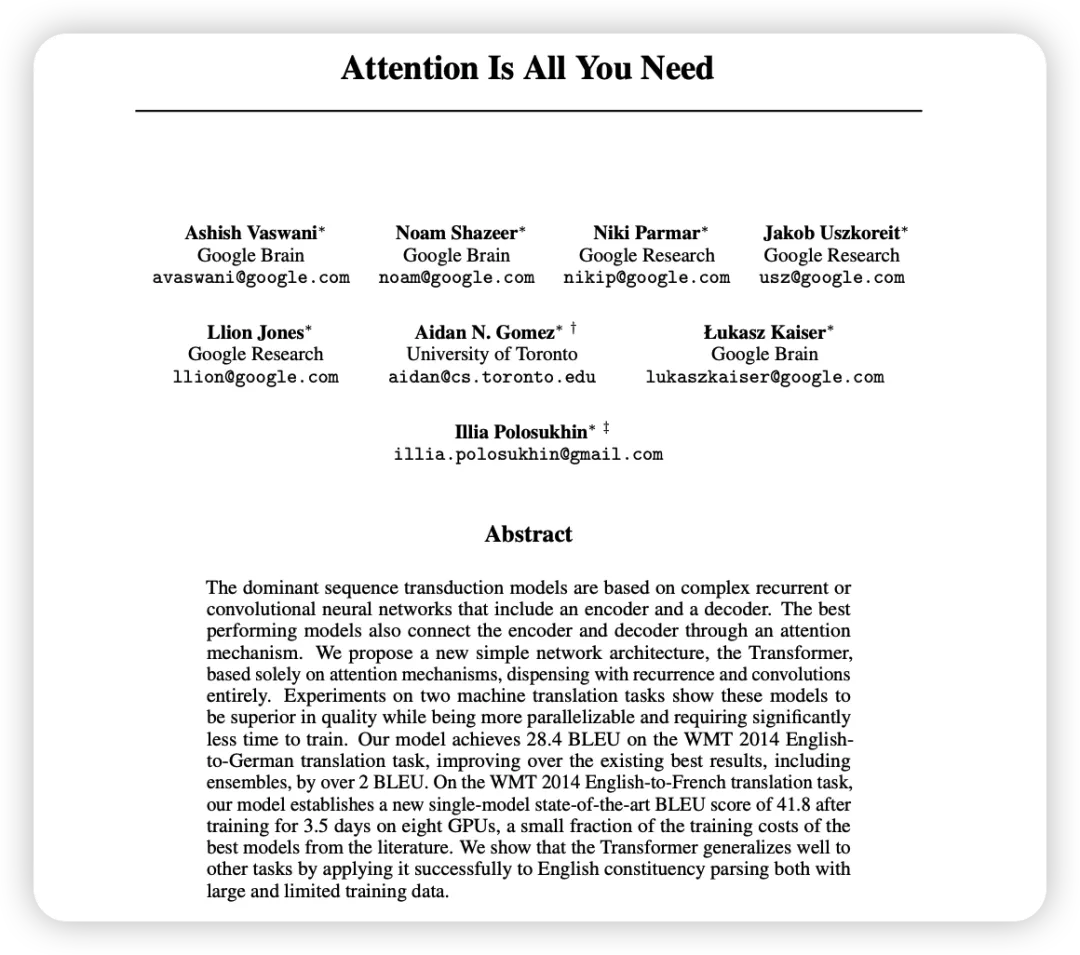
这个「注意力机制」(Attention Mechanism)到底解决了什么根本问题?
可以这样来理解:在 Transformer 出现之前,模型处理句子的方式,就像一个记忆力有限的学生,只能一个词一个词地顺序阅读。
因此当句子很长时,读到后面,就忘了前面讲了什么。
而 Transformer 架构,则像是一眼看完整段话,它能立刻判断出所有词语之间的关联强度,知道哪些词是核心,应该被赋予最高的「注意力」。
这个架构带来的提升是碾压性的。
论文数据显示,在某些任务上,Transformer 可以用比过去少 10 到 100 倍的计算量,达到更好的效果。
这个革命性的架构,成为了后来所有大语言模型(包括我们今天熟知的 GPT、Gemini、Claude)的基石。
可以说,没有 Transformer,就没有今天的 AI 盛世。
模型越来越大,也带来了一个新问题:每次处理一个简单的任务,都要调动整个庞大的模型,非常浪费资源。
于是,诞生出了一个更聪明地「偷懒」的办法——稀疏模型。
你可以把一个大模型想象成一个庞大的公司,里面有数学家、作家、程序员等各种专家。
当遇到一个数学问题时,你没必要让全公司的人都停下工作来思考,只需要激活那个「数学家」就行了。
这种「按需激活」的方式,让模型的运行效率大大提升,训练成本降低了约 8 倍。
今天很火的 Gemini 就是稀疏模型。
解决了底层架构和效率问题后,便开始探索如何让 AI 变得更「聪明」。
他们发现了一个有趣的现象:如果你直接问 AI 一个数学题的答案,它可能会算错;
但如果你让它「像学生做题一样,写下详细的解题步骤」,它的正确率就会飙升。
这就是后来广为人知的「思维链」技术。
另一个重要的技巧叫「蒸馏」。
想象一下,让一个学识渊博的「教授模型」,去教一个「学生模型」。
教授不仅告诉学生正确答案是「小提琴」,还会告诉他,「钢琴」和「小号」也沾点边,但「飞机」就错得离谱了。
这种带有丰富信息的教学方式,能让学生模型学得更快、更好。
当模型通过海量数据预训练,掌握了世界的基本知识后,还需要最后一步「精雕细琢」,让它变得更「听话」、更「能干」。
这就是「强化学习」发挥作用的地方。
你可以把它理解成一套「奖励机制」。
比如,让 AI 学习写代码。
当它生成的代码能够成功编译运行时,就给它一个「奖励」;如果代码还能通过所有单元测试,那就给一个「大奖」。
同样,在数学领域,当它生成的证明过程被验证是正确的,就给它奖励。
通过无数次的试错和争取奖励,AI 就能在特定领域的能力上,实现自我迭代和进化。
这个效果有多夸张?
Jeff Dean 在分享的最后,给出了一个震撼的对比:
就在 2022 年,Gemini 的数学能力,还停留在解决「约翰有四只兔子,又得到了两只,他现在有多少只兔子?」这种水平的小学应用题上。
而 2024 年,2.5 Pro 已经能够解决国际奥林匹克数学竞赛(IMO)金牌水平的难题。
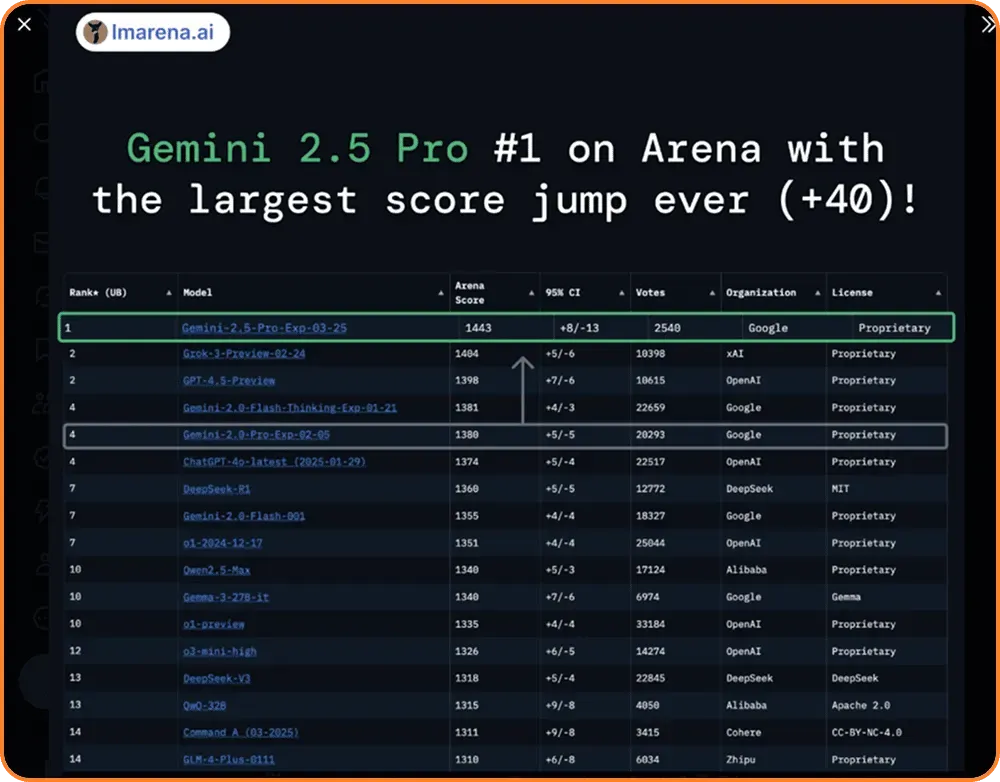
从小学算术到奥数金牌,只用了短短两年。
回顾这整个历程,你会发现,AI 的强大并非一蹴而就。
它不是某个单一技术的突破,而是硬件、算法、架构、数据理念等多个领域,在过去十几年里一系列关键创新的「连锁反应」和「指数级叠加」。
正是因为有了这漫长的铺垫和积累,我们今天才能体验到 Gemini、ChatGPT、Claude、DeepSeek 等这样令人惊艳的产品。
它们是站在过去所有这些创新的肩膀上诞生的。
AI 的进化仍在继续,理解了它的过去,我们或许才能更好地想象和塑造它的未来。
