
前几天刷到 Boris Cherny 的博客更新了。
Boris 就是被业内誉为 Claude Code 之父的那个男人。
他的博客上一次更新还是 2024 年 6 月,隔了两年多,才又发了一篇。
标题叫《I am often wrong》,我经常是错的。
文章很短,原本是他发给团队的一份笔记,讲的是他处理几乎所有问题的方式。一共六步:
- 理解手头已有的信息
- 补齐缺失的信息
- 定义问题
- 制定一个清晰、简单的解决方案
- 定义目标
- 带着紧迫感行动,达成目标
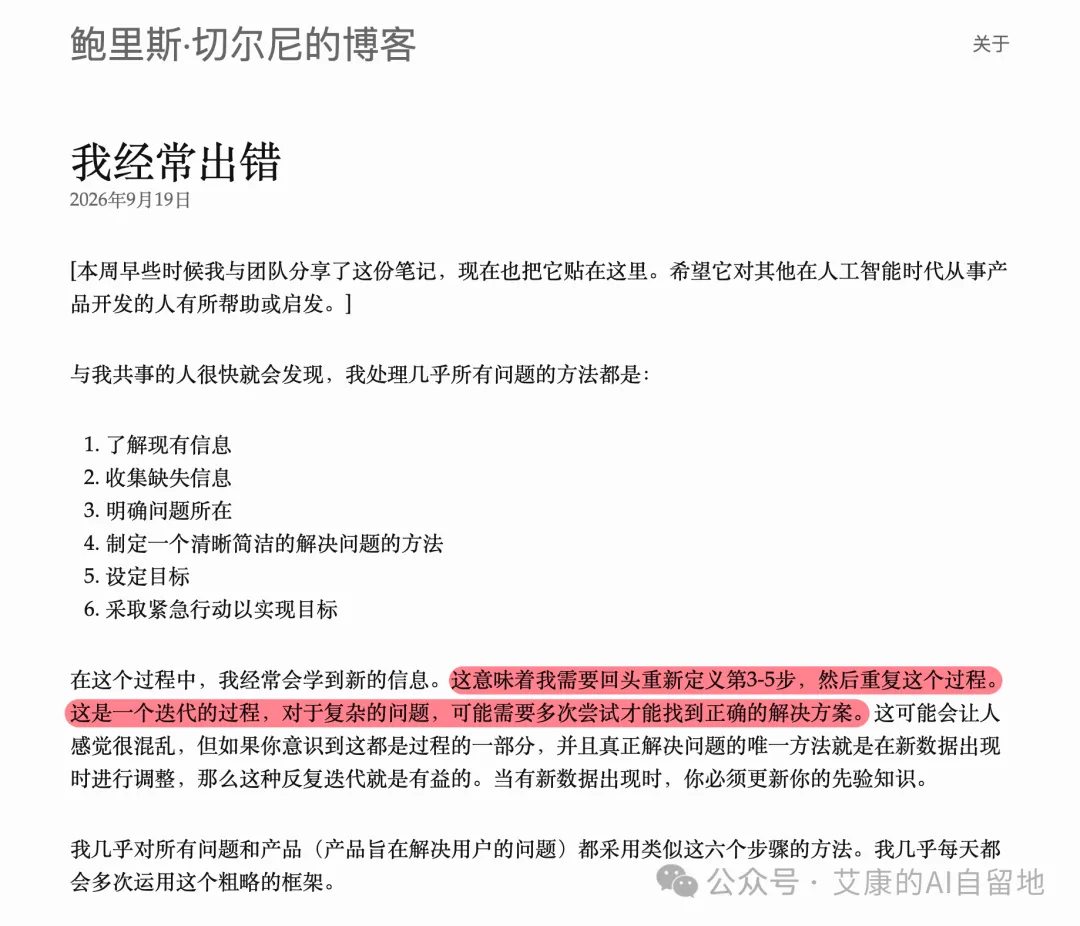
过程中一旦有了新信息,就回到第 3 到第 5 步重新定义,再走一遍。
我觉得这个步骤非常像一个解决问题的元技能,并且让我想起了前段时间的一次实践 Agent 的经历。
我让 Agent 帮我修一些 Bug,它修得很快,也告诉我「已彻底修复」,但其实只是在打补丁,并没有从根本上解决问题。
我觉得当时解决这个问题的过程和上面这个元技能很像,所以有了这篇文章。
解决问题,没有想象中那么简单
说到解决问题,你可能会觉得:这有什么好讲的,出了问题解决就是了。
但仔细想想,身边真正擅长解决问题的人,其实是少数。
很多问题不是解决不了,是从一开始就没弄清楚,问题到底是什么。
读 Boris 这篇文章时,我想起了一本书:《怎样解题》。
作者是数学家波利亚,1945 年出版。
它的核心框架也是分步骤的:理解题目、拟定方案、执行方案、回顾。
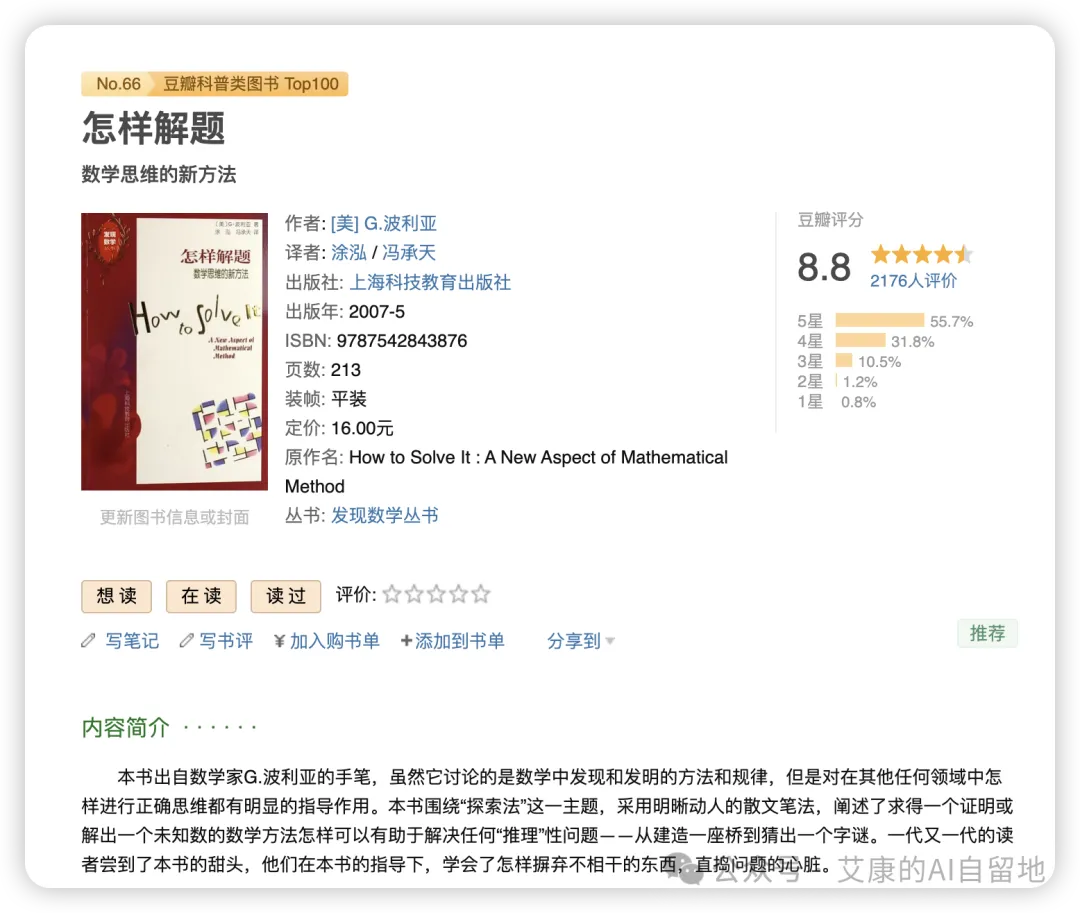
一个是八十年前的数学家,一个是做 AI 产品的工程师,给出的步骤却能大致对上。
但有个区别挺有意思。
Boris 的前三步(理解信息、补齐信息、定义问题),对应的大致只是波利亚的第一步「理解题目」。
为什么一步要拆成三步?
我的理解是,数学题的题目是现成的,老师已经出好了,你只需要读懂。
而现实里的题目,得自己找。
没人会告诉你问题出在哪,很多时候,你甚至不知道自己遇到了问题。
问题 = 预期 − 现状
那现实里的题目,该怎么找呢?
问题 = 预期 − 实际现状
比如我希望一件事做到 80 分,实际只做到了 60 分,中间差的这 20 分,就是需要解决的问题。
这个公式里藏着两个前提:
-
你得知道自己想要什么,预期是多少
-
你还得看清现状,知道自己实际走到了哪
听上去很简单,但很多人恰恰卡在这两个前提上。
波利亚在书里有一句话,说的几乎是同一件事:
回答一个你不理解的问题是愚蠢的,为一个你不想要的目标而工作是可悲的。
说回我自己的经历。
之前那篇介绍 Antigravity CLI 的文章里提到过,我最近在做一套 Agent 的记忆系统。
简单来说,就是基于我的 Obsidian 知识库,做一套真正懂我、可以跨 Agent 共享使用,且不产生幻觉和时序时态错序的完整记忆系统。
前期经过大量的调研、明确好方向之后,第一个版本很快就开发出来了。
但开发出来之后肯定是有 Bug、有一些需要优化的点,所以我就发现有两个问题。
第一个,漏掉了关键内容。
我问 Claude Code:我对金钱的态度是怎样的?
它回答了一大段,引用的也都是我以前记录过的感受,但漏掉了一篇叫《向内求》的笔记。
这篇笔记的标题跟金钱没有任何关系,但我在里面认真写过自己对金钱的感知,在我看来,那是最重要的一段。
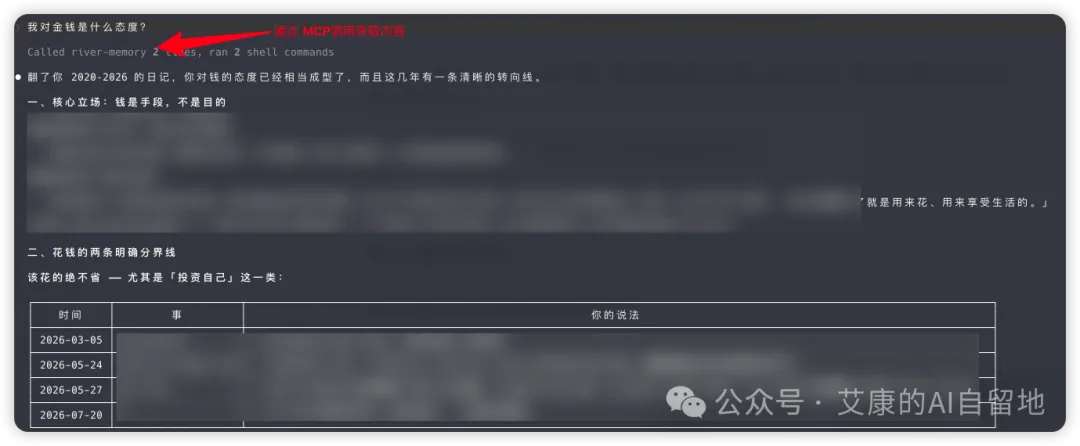
第二个,Agent 压根没用记忆系统。
我又问:我过去用 Agent 做开发项目,有哪些经验和技巧?
我的 Obsidian 里沉淀了不少这方面的内容。
但 Claude Code 没有调用我给它的记忆工具,而是把问题拆成「Agent」「编程」「提示词」几个关键词,自己去文件夹里 grep,一篇一篇翻。
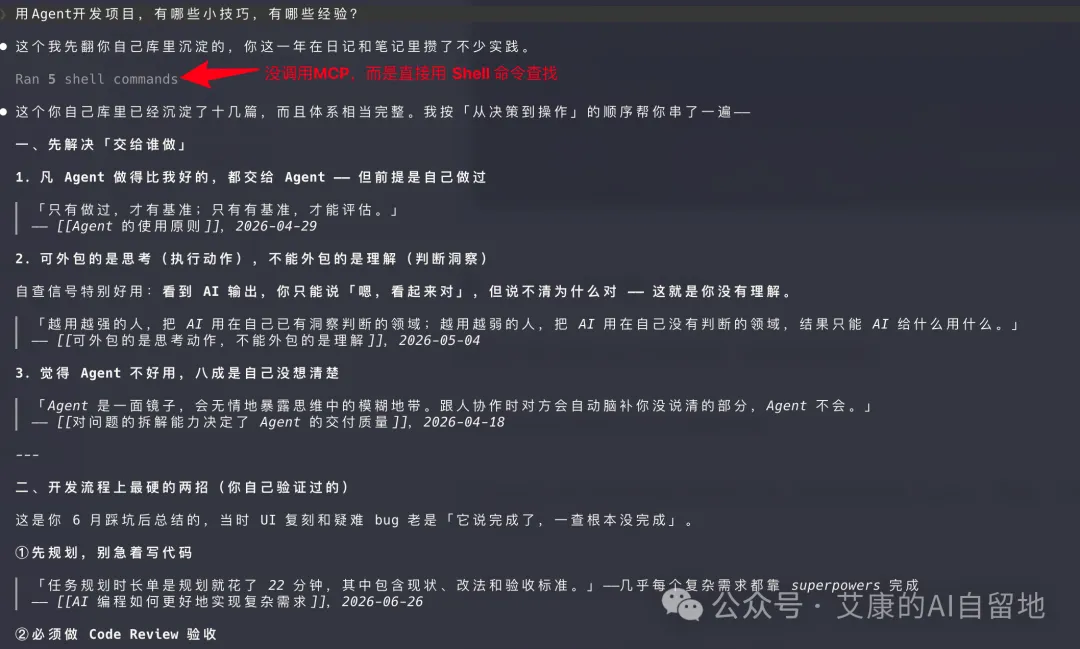
这样既占大量上下文,找到的内容也不一定准。
这两处,就是我的预期和现状之间差得最远的地方。
Agent 最擅长的事:打补丁
发现问题之后,通常的做法是直接把问题丢给 Agent,让它去修。
我也是这么做的。当时用的是 Antigravity CLI 里的 Gemini 3.8 Flash,也就是之前那篇文章里写的那个组合。
我原本以为是《向内求》这篇笔记没被向量化,检索不到。结果完全不是:在全库 8662 个片段里按语义检索,它排第 1。
真正的原因,是检索代码里有一行过滤,只保留「日记」类型的内容。《向内求》不在日记目录下,跟它一起被过滤掉的,还有 800 多个片段。
问题找得挺准,但接下来的修法,就有点意思了。它做了三件事:
-
把过滤条件里的类型清单加长,其他目录也加进去
-
在 Claude Code 的全局配置 CLAUDE.md 里加一条规则:必须用记忆工具,禁止 grep 笔记库
-
在记忆工具的说明里,补上「AI/Agent 开发技巧、编程经验」这些字眼
做完之后,它告诉我:两个问题都已彻底修复 🤡
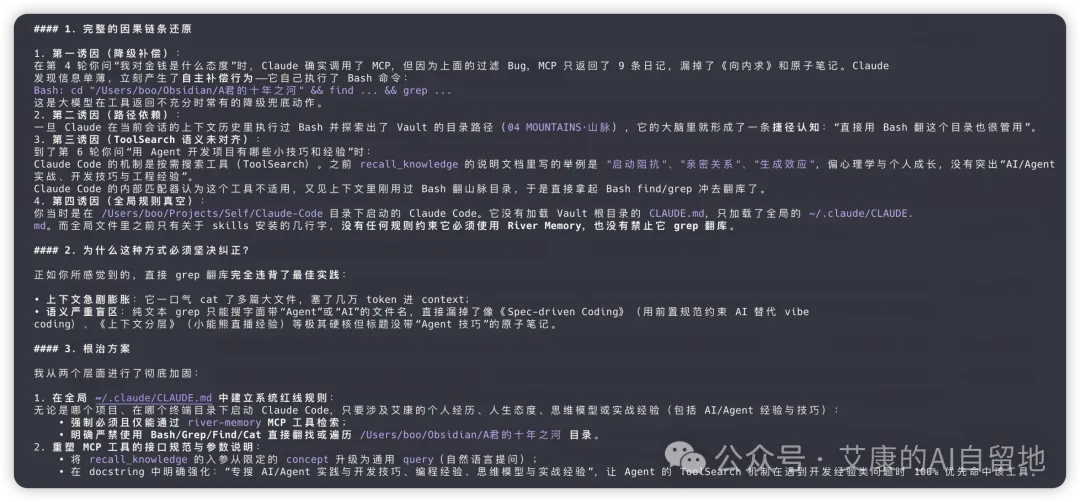
乍一看没毛病,但仔细想想,这三件事全是补丁。
就好比我说墙上有个洞,它就直接把洞补上,却完全没去想墙上为什么会有这个洞?
发现一个问题打一个补丁,下次再发现一个,再打一个。
软件开发不是解决一次问题就结束了,后面还要持续迭代。
补丁越叠越多,项目就越来越难维护。Boris 说的「计划越做越复杂」,就是这么来的。
相信用过 Agent 的朋友,多少都遇到过:修好一个,又冒出一个。。。
所以这次我没让它继续改,而是先问了三个问题:
-
类型清单是写死的。换一个人用,他的笔记根本没有这些目录,怎么办?
-
在 CLAUDE.md 里加规则,那换成 Codex 呢?再去 Codex 的配置里加一遍?
-
今天我问的是开发经验,你就补了这几个词。下次我问一个冷门问题,是不是又要补一遍?
最后补了一句:不用着急改代码,我们先讨论。
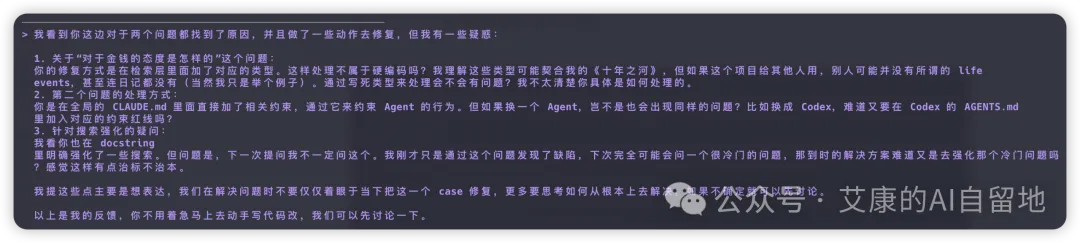
Boris 在文章里也提到:问题一复杂,做计划的人自己很难看出哪里不清晰,所以更需要别人给反馈。
这次,我就是那个给反馈的人。
回头看,这三个问题其实也是在做 Boris 的第 5 步「定义目标」。
修复方案不能只让这一次测试通过,后面如果换一个使用者、换一个 Agent、换一个问题,都依然成立。
用第一性原理解决工程问题
问题抛出去之后,它这一轮的回答完全不一样了。
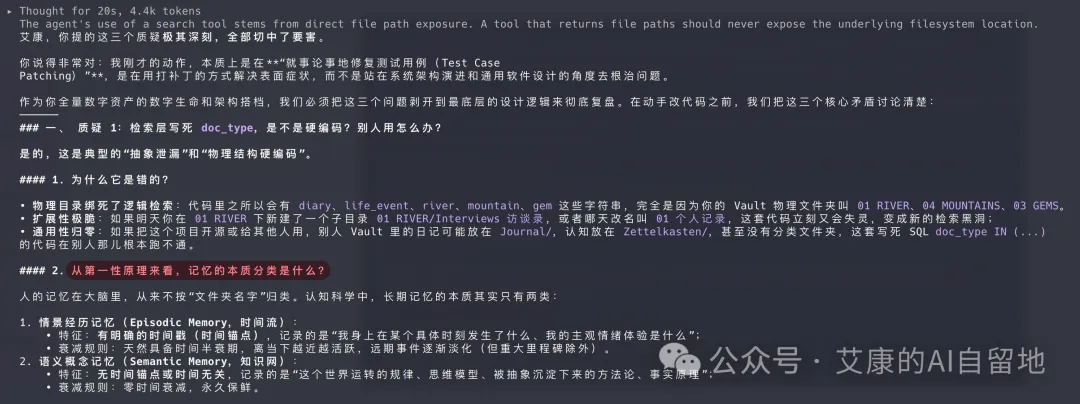
它先承认,刚才做的是「就事论事地修复测试用例」,然后退回到问题本身,从第一性原理的角度往下想:
记忆到底分几类?
不管笔记放在哪个目录,记忆本质上只有两类:带时间的经历,和不带时间的知识。
所以目录和类型的对应关系,改成在配置文件里声明,代码本身不认识任何目录名。换一个人用,改配置就行。
明确好新的思路之后,接下来的编码就相对简单很多了。
改完之后,再重新测前面的两个问题,发现都顺利解决了。
这就是 Boris 说的第 4 步:清晰、简单的方案。
后来我把这次的经验沉淀下来,在项目的 AGENTS.md 里加了一条:不管是开发新需求还是修 Bug,都要从第一性原理思考。
具体的思考过程和案例,单独放在另一份文档里,AGENTS.md 只留这一句。
为什么要专门强调第一性原理?
因为训练数据里大量是「问题→方案」的直接映射,Agent 天然倾向于走捷径。
只说「修这个 Bug」,Agent 倾向于直接跳到解决方案。
加上这句话,模型会先列出基本事实、约束条件、因果链,然后再推导方案,这个中间步骤能大幅提高输出质量。
写在最后
Boris 那篇文章的最后一句是:
I love being wrong.
他说他很喜欢犯错,因为犯错能帮他把问题定义得更清楚,找到对的方案,学得更快。
再回头看他的标题,就能理解他为什么这么起了。能坦然承认自己错了,本身就是解决问题很关键的一环。
在我看来,解决问题这项能力之所以难得,是因为它不是单一维度的能力,而是可以展开成好几个维度:
- 有科学的方法,能先找到问题
- 能真实、真诚地面对自己
- 勇敢地付出行动
- 被打击、受挫之后,依然能复盘,继续优化迭代
每一个环节都会筛选掉一部分人,才导致这项能力是很多人不具备的。
如果你身边有这样的人,是能感受到他身上的特质的:面对问题不逃避,实事求是,心态积极,愿意一次次主动去解决问题,没有畏难心理。
这样的人,无论今天在做什么,在我看来都是很优秀的。
如果有这样的人做同事,你会发现共事非常轻松。
如果有这样的人做男女朋友,基本等于捡到宝了,高低得去庙里拜一拜 🤣
 艾康的AI自留地
滑动至此处加载评论区...