
试完 LibTV 的 Star Video 2.0,说实话,有点上头
评测 LibTV 新上线的视频生成模型 Star Video 2.0:上传一段参考视频即可自动拆解剧本分镜、批量生成画面与视频,约 30 分钟就能拿到一支带完整叙事节奏的成片。
先来看一段视频。
这是一支完整的电商产品广告片,有分镜,有转场,有节奏,有配乐。
这支视频不是我一个镜头一个镜头拼出来的。
是我上传了一段参考视频,LibTV 基于这段参考自动拆解出了剧本和分镜,然后我批量生成了所有镜头,简单剪辑一下就出来了。
整个过程,大概 30 分钟。
用的是 LibTV 最新上线的视频生成模型:Star Video 2.0。
做 AI 视频,目前最花时间的环节是什么?
可能很多人跟我一样,觉得现在 AI 生成单个镜头的能力已经很强了。
画质高、风格丰富,几分钟就能出一段看起来不错的画面。
但真正要把这些镜头组成一支完整的视频,情况就完全不同了。
哪怕有 AI 加持,目前很多人做一支短片的实际流程还是这样的:
先写剧本,根据剧本再生成分镜脚本,然后切到图片生成工具,一张一张跑出每个分镜的画面。
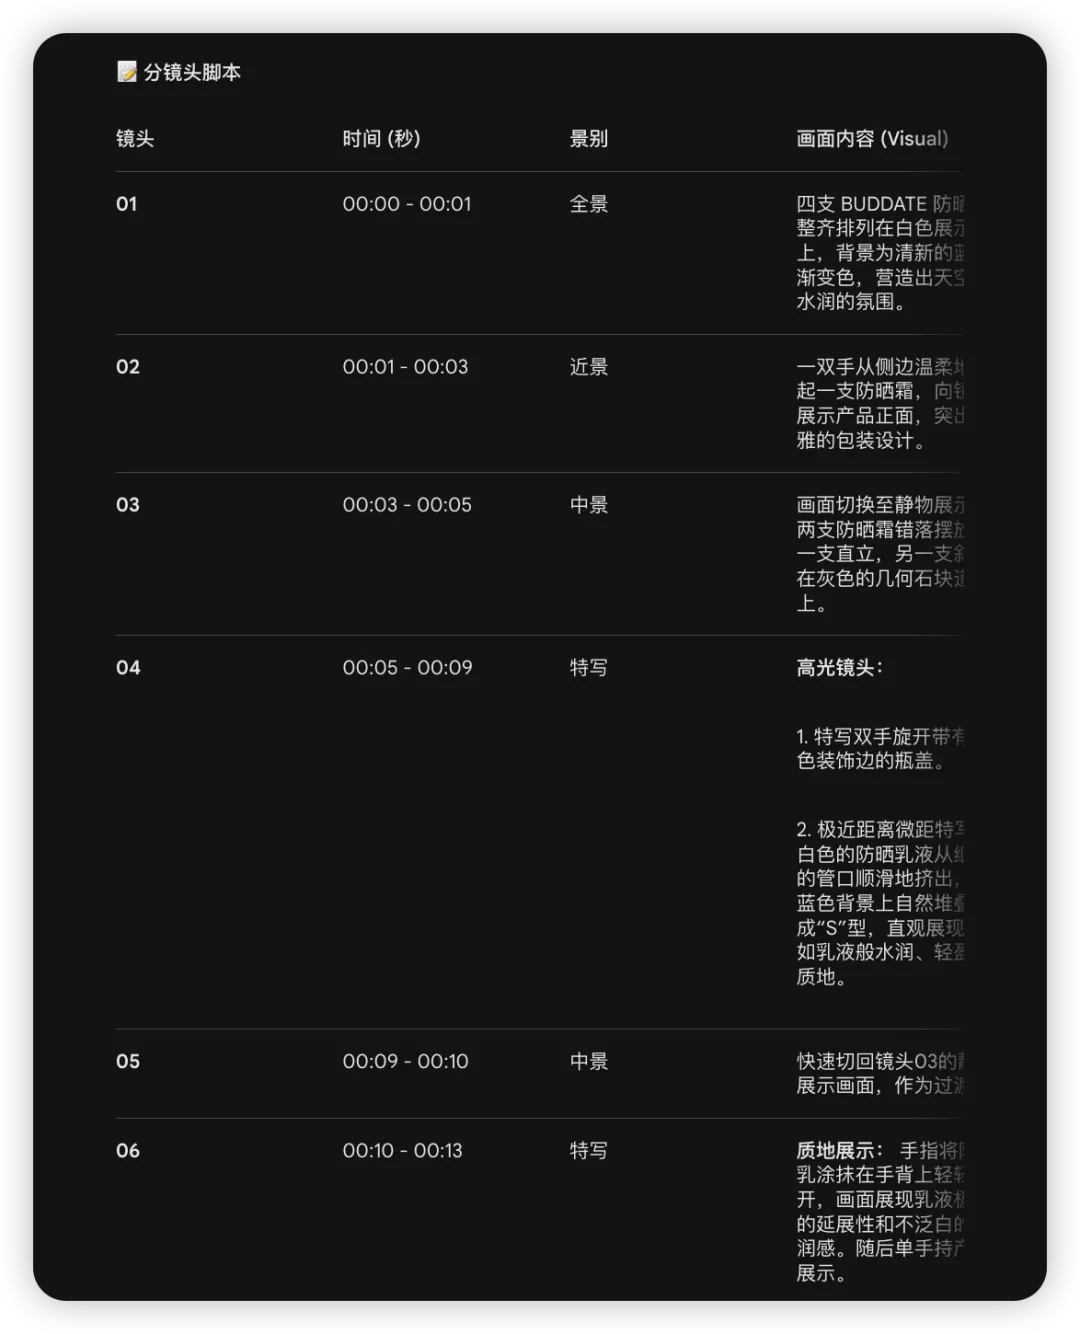 像这样👆
跑完之后再切到视频生成工具,一个镜头一个镜头地生成。
都跑完了,还得打开剪辑软件,把这些零散的片段拼起来、配音、配乐、调节奏。
一支 30 秒的短片,可能真正花在「生成」上的时间只占两三成,剩下全是在各个工具之间搬运素材、修补一致性、反复抽卡。
Star Video 2.0 不一样在哪
LibTV 最近上线的 Star Video 2.0,解决的就是这个问题。
它不是又一个「画质更好」的视频生成模型。它的核心变化是:从生成镜头,变成了生成叙事。
这句话听起来有点抽象,我用自己这次做广告片的过程来讲。
第一步,我上传了一段参考视频。
就是一支我觉得节奏和风格不错的现成广告片。
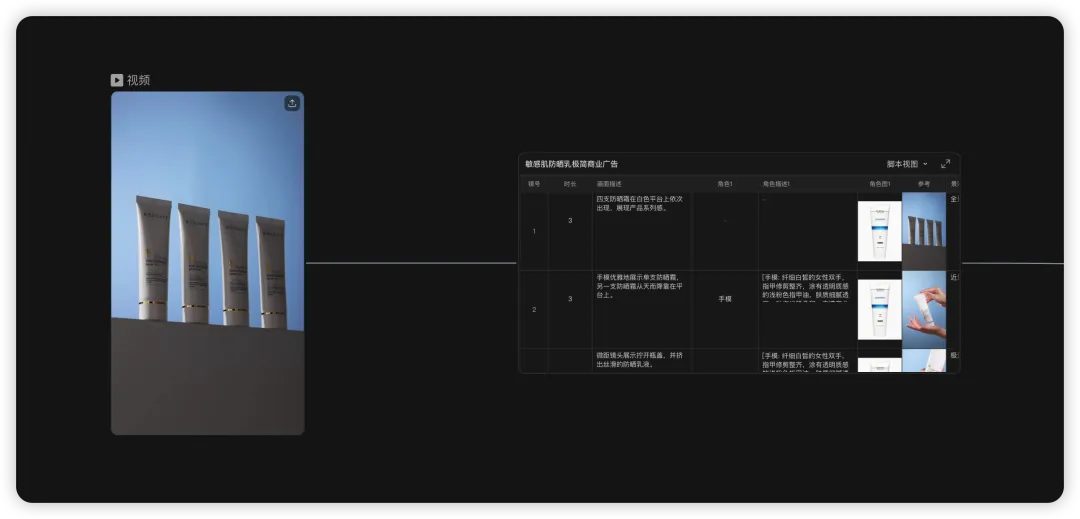 上传之后,LibTV 直接帮我把这段视频「读懂」了——它自动分析了原片的镜头结构、节奏和叙事逻辑,然后生成了一套对应的分镜脚本。
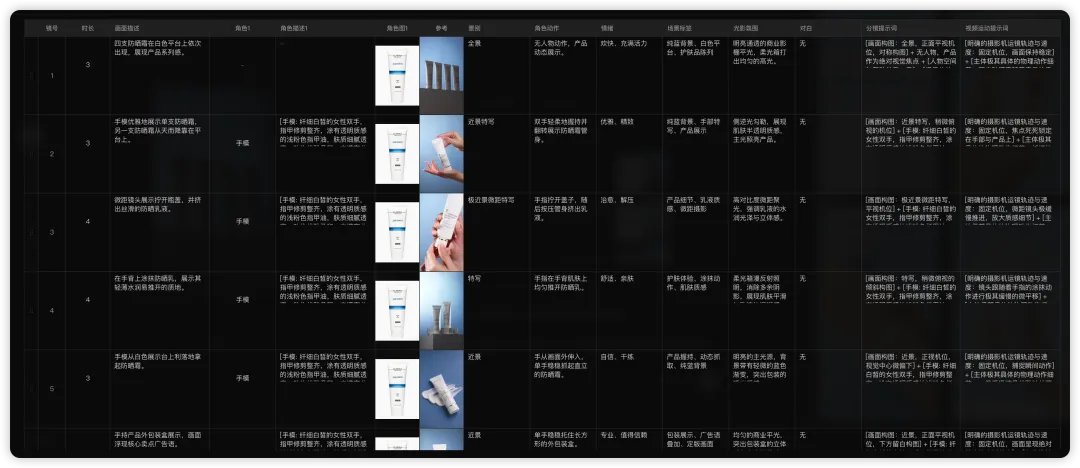 我不需要自己从零写剧本,也不需要一个镜头一个镜头去描述「第一个镜头拍什么、第二个镜头拍什么」。
给它一段参考,它自己就理解了整个叙事结构。
第二步,一次性生成全部分镜图。
脚本出来之后,我直接让它批量生成所有分镜的画面。不是一张一张跑的,是一口气全部出来。
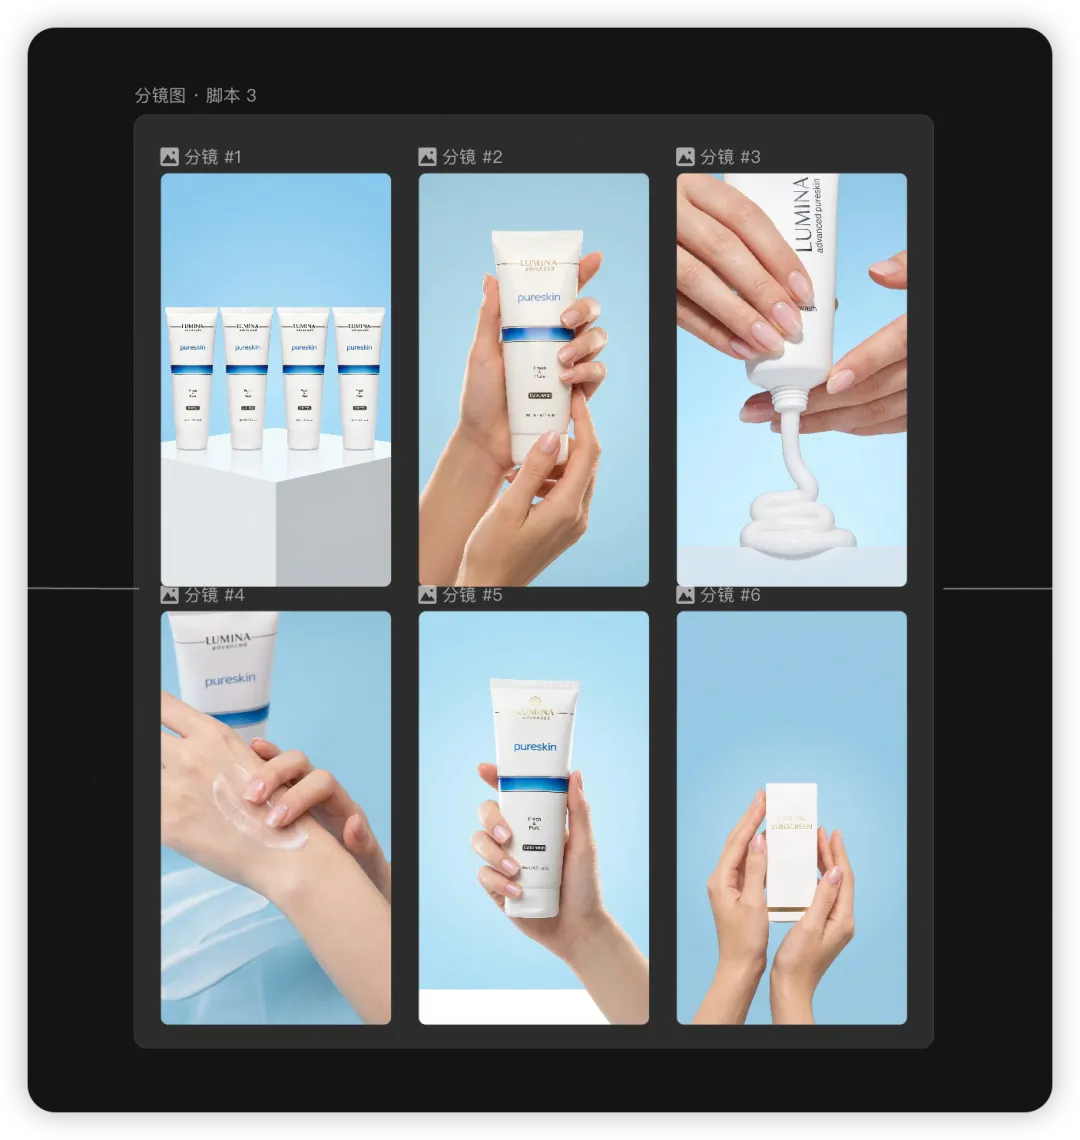 这里有个细节值得说一下:画面之间的一致性是模型在生成时就控制好的。
产品包装、场景色调、整体风格,在上一步生成分镜脚本时就提前写好了。不需要我手动去挑、去修、去反复比对哪张跟哪张搭不搭。
第三步,批量生成视频。
分镜图确认之后,选 Star Video 2.0 模型,批量跑视频。
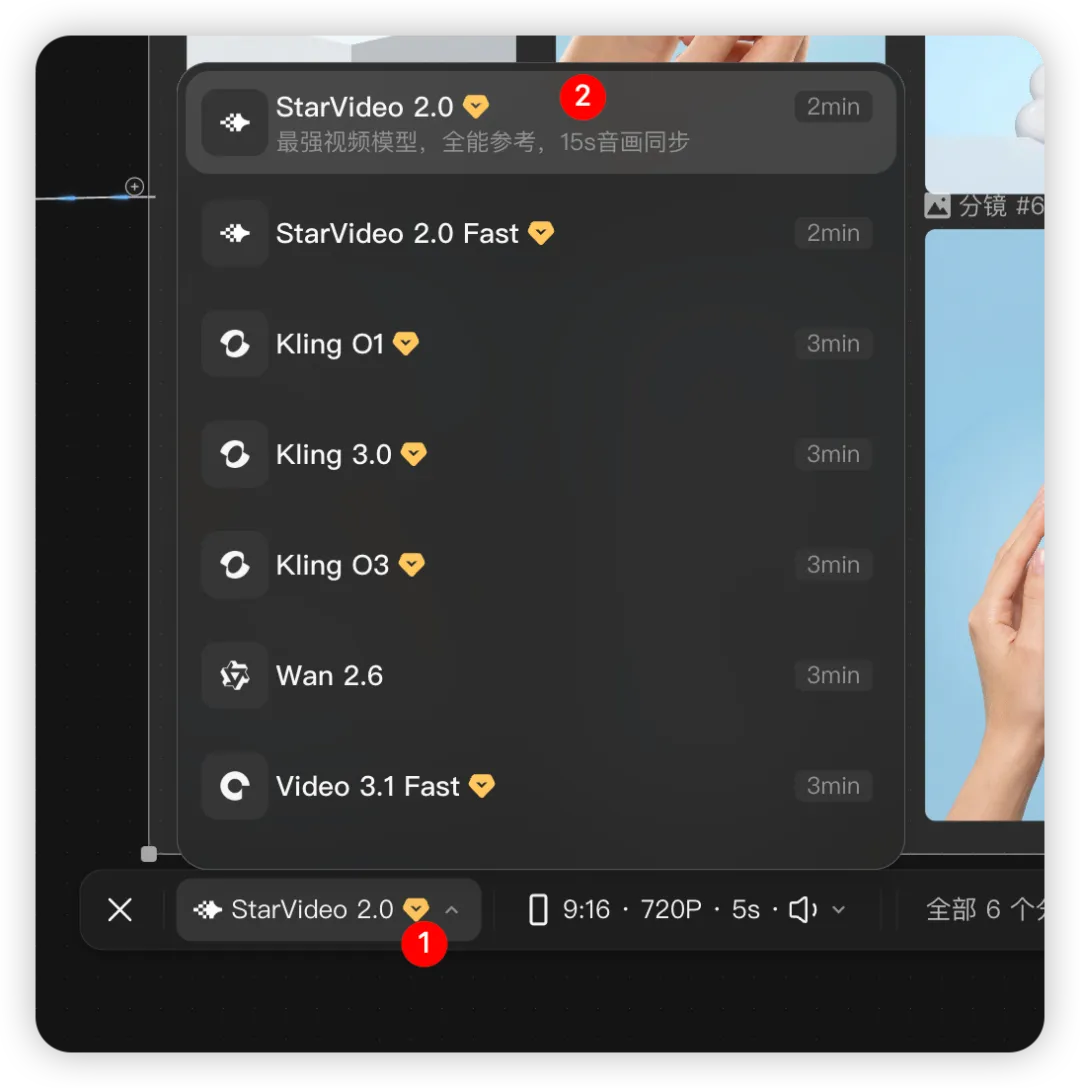 每个镜头的运镜方式、时长、节奏,模型根据脚本自动匹配。该推的推、该切的切,镜头语言是跟着叙事在走的。
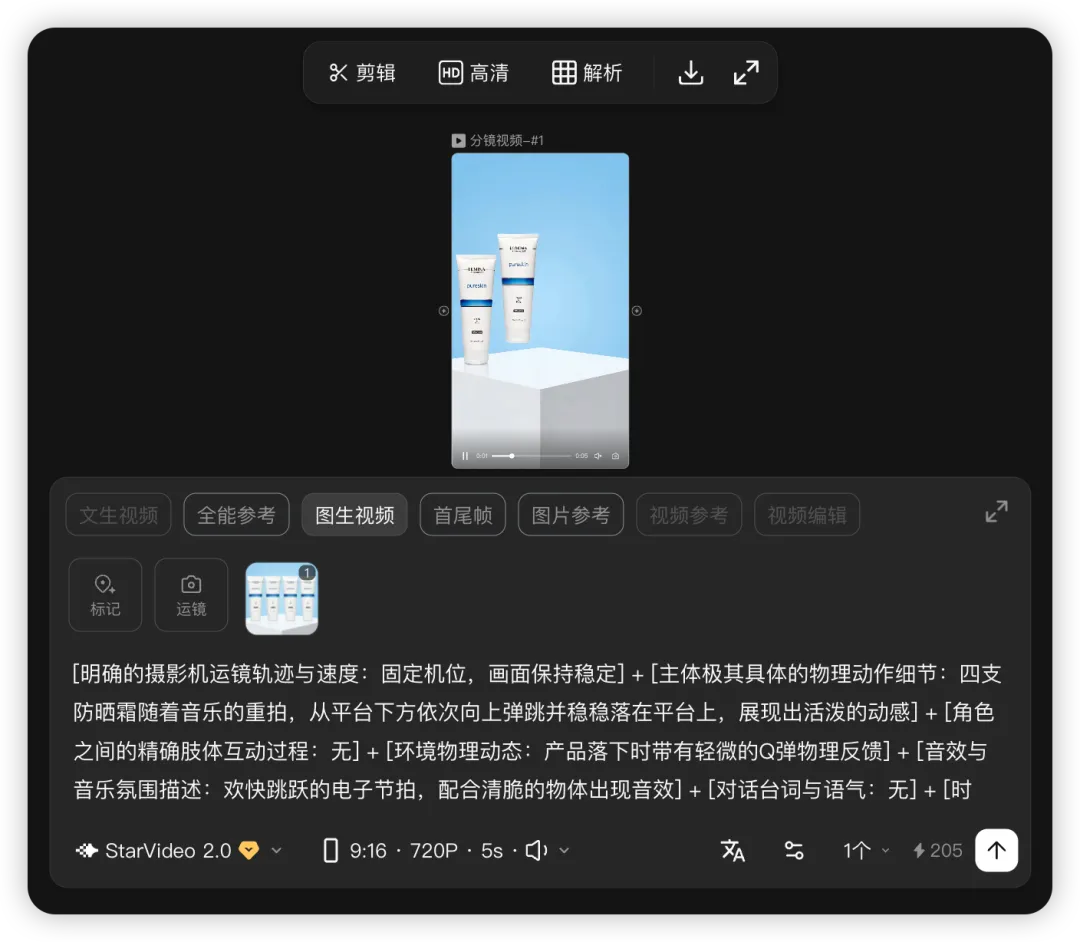 另外 Star Video 2.0 支持音视频一体化生成——配乐和环境音跟画面同步产出,不需要后期单独找素材再贴上去。
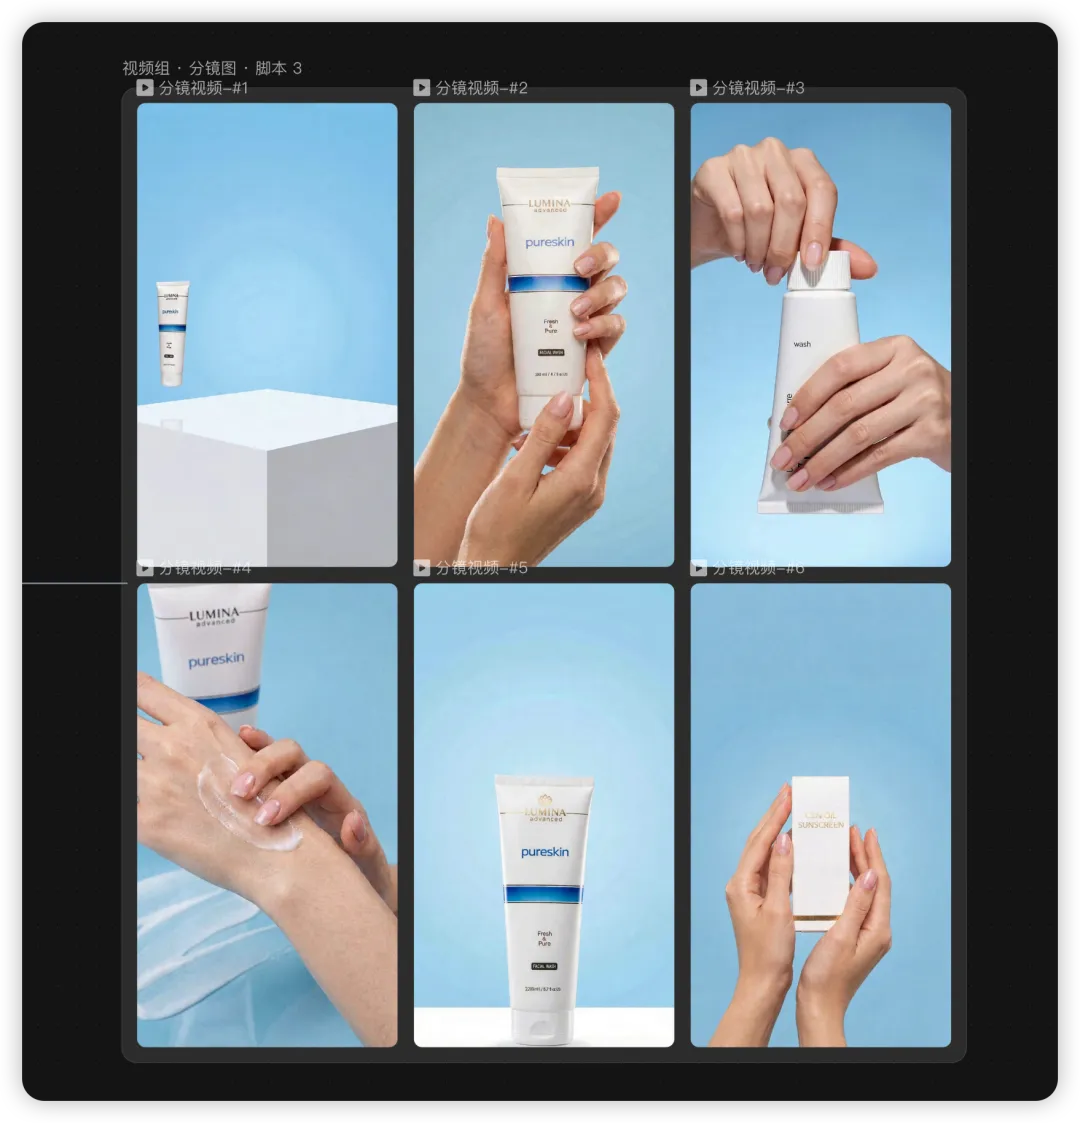 最后,在画布上简单剪辑,直接导出。
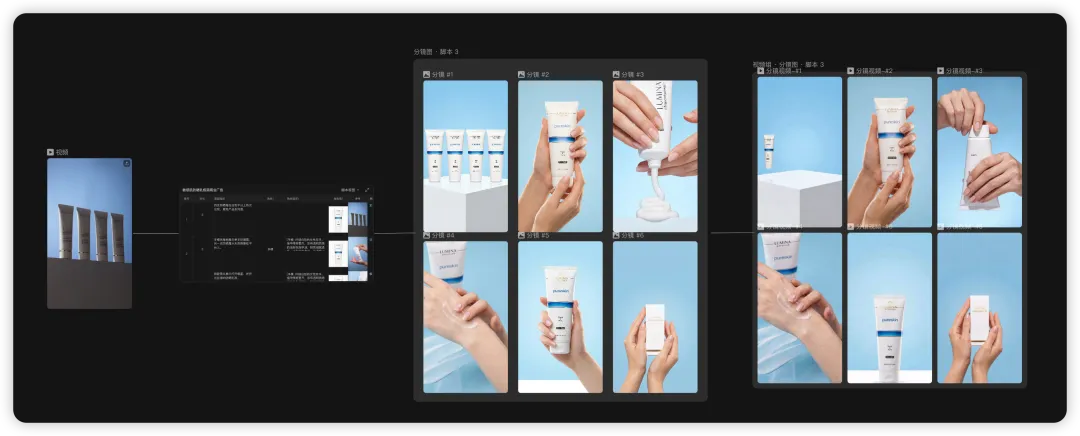 所有素材都在 LibTV 的画布里,排序、微调、剪辑、导出,全程不用切任何其他工具。
几个实际体验下来的感受
第一,速度是真的快。
从上传参考视频到拿到完整成片,全程大概 30 分钟。
全程不用切换工具,全都是在 LibTV 的无限画布里完成,省去了各种工具之间切换的时间。
如果换成以前的做法,得先去一个 AI 工具里写脚本,再去另一个 AI 工具里生成图片,再去第三个 AI 工具里跑视频,再打开剪辑软件拼接。
每切换一次工具,就要重新上传素材,一支 30 秒的短片,工具之间的搬运和等待加起来,可能比真正的创作时间还长。
第二,批量生成 + 多版本对比是真的好用。
无论是生成脚本、生成分镜图、生成视频,全部都是批量操作。
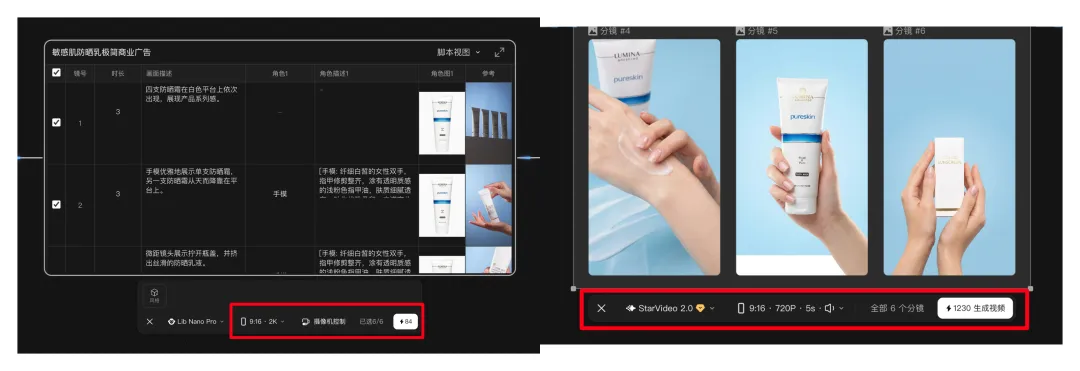 生成分镜图的时候,对其中几个镜头不太满意。
直接让它重新跑了一版,两个版本摆在画布上一对比,马上就能做判断。
这种「先铺量再筛选」的创作方式,只有在成本够低的时候才做得起。
LibTV 在这方面确实比较舍得给,同样的预算,在这里能跑的量比大多数同类工具多出不少。
第三,天然适合做需要多镜头叙事的内容。
做完上面的电商广告之后,我试了几个完全不同的场景,发现 Star Video 2.0 的适用范围比我预想的要宽。
品牌宣传片、服装展示、沉浸式样板间参观,我各跑了一个,都是直接给提示词或者扔一张参考图就出来的。
提示词:帮我生成一个讲述宜家这个品牌的宣传片。提示词:帮我生成一个展示男士冲锋衣的视频,背景白色干净。提示词:参考图片 1 和图片 2,生成一段沉浸式的样板间参观视频。严格按照图片 2的分镜顺序生成视频,模拟真实看房的行走路线。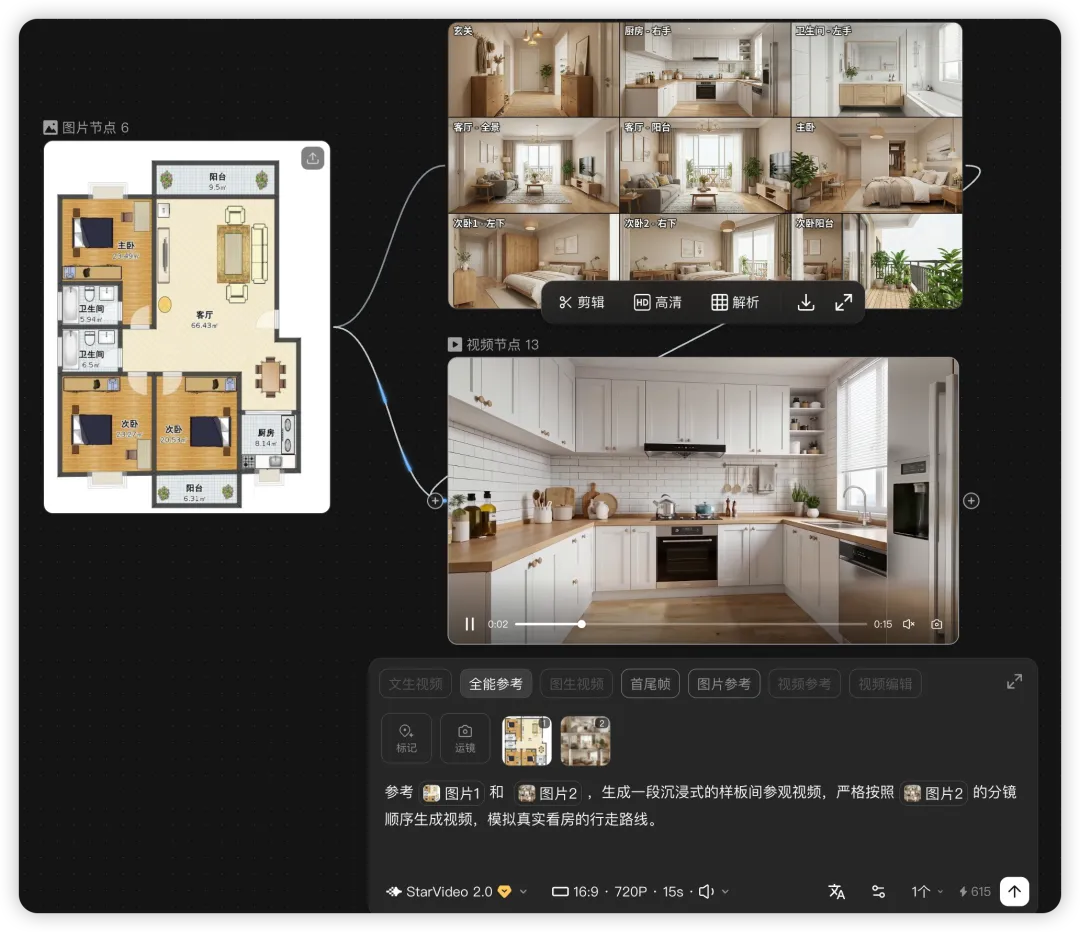 这几个视频都不是单个镜头的生成,都有完整的叙事节奏——镜头之间有衔接、有逻辑、有推进感。
这些不是我手动编排的,是 Star Video 2.0 根据输入自己理解的。
如果觉得我的案例,都比较简单,那不是工具的问题,是我的问题 🤣 不信你看 👇
下面是一些其他创作者用 Star Video 2.0 做出来发布在官网的作品,题材和风格跟我做的完全不同,大家可以感受一下:
@生白 AIGC
@Al 智帧局
@KUNC 荒骷髅
所以整体感受下来,Star Video 2.0 对需要多镜头叙事的内容支持是最好的。
比如短剧、剧情向内容、品牌故事广告等,这些天然就需要多个镜头之间有连贯的角色、情绪和节奏。
以前用 AI 做这类内容最头疼的就是镜头之间的衔接感,Star Video 2.0 因为是从叙事层面去理解和生成的,所以在这类场景下优势比较明显。
写在最后
Star Video 2.0 模型目前已经在 LibTV 的团队版上线了。
对于需要批量产出视频内容的团队来说,这个额度真的非常足了。
感兴趣的右边直达官网👉 https://www.liblib.tv/
