
如何让 AI Agent 跑一整晚,早上起来直接「收菜」
我现在睡前把任务交给 Agent,早上起来收菜。关键是提前聊清需求和验收标准,用 Superpowers 拆成小任务,再靠测试、小步 Commit 和独立审查让它自己跑一整晚。
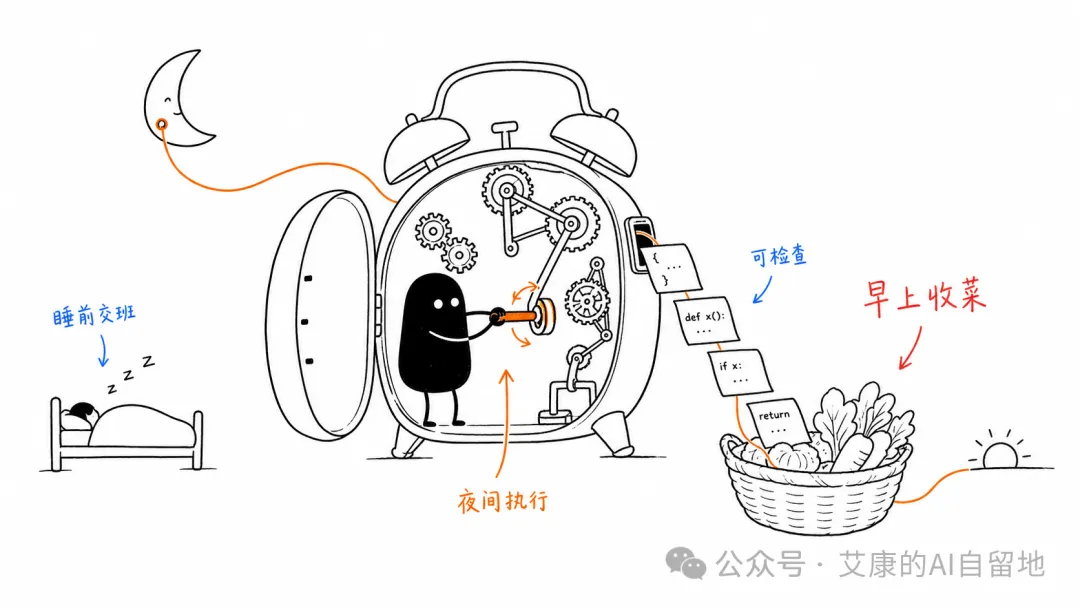
今天早上 7 点 30 分,我刚起床,第一件事就是打开电脑,看了一眼昨天睡觉前提交的任务。
任务显示已经完成。
这个过程,有点像早上起来「收菜」。
睡觉之前把任务交给 Agent,第二天睁开眼睛,看看它一晚上干了多少活、留下了哪些 Commit、测试有没有通过、还有什么问题需要自己处理。
最近我越来越喜欢这种使用 Agent 的方式。
因为 AI Agent 的执行能力已经很强了,很多复杂任务一跑就是几个小时。所以除了白天坐在电脑前,看着它一行一行写代码,也能把一部分复杂任务放到晚上去执行。
我去睡觉,它继续干活。
大多数人可能还在「照看 Agent」
这让我想到了前段时间看过的一篇文章:《AI agent 到底怎么才算真正落地》。
作者参加了旧金山 Inngest 举办的一场 AI in Production 小型聚会,现场有 Cursor、Inngest、Vapi 等公司的一线工程师和创始人,聊的都是 AI Agent 真正进入生产环境后遇到的问题。
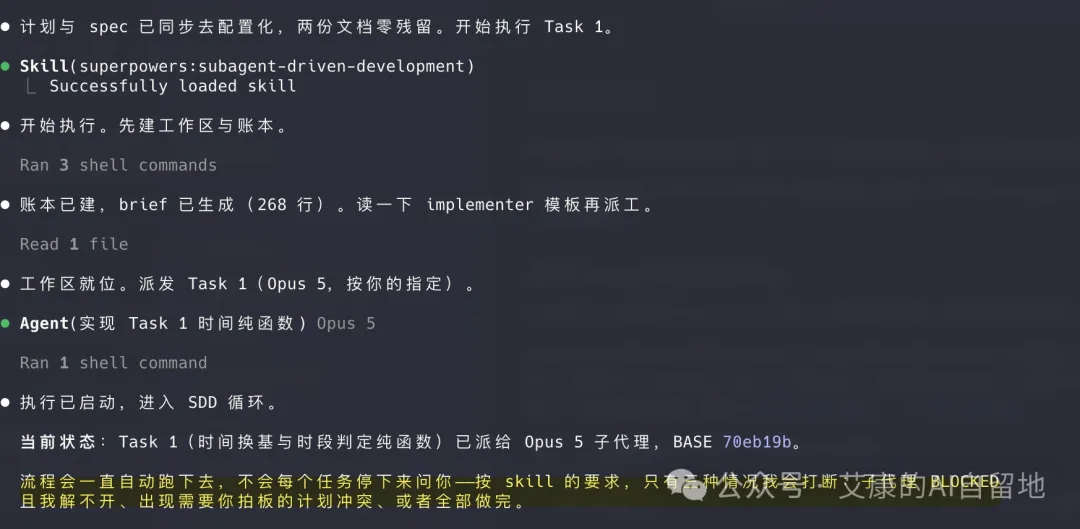
其中,Cursor 的 Kash Yechuri 分享了一个很有意思的框架:AI 编程正在经历三个阶段。
第一个阶段,是 Copilot。
我们用 GitHub Copilot 补全几行代码,用 ChatGPT 写一个函数,用 Claude 帮忙解释报错。
这个阶段,人是主导,AI 只是帮忙。你写到哪里,它补到哪里。
第二个阶段,是 Agent。
我们开始把一个完整需求交给 Claude Code 或 Codex。Agent 可以读代码、修改文件、运行命令、帮我们完成几十分钟甚至几个小时的工作。
但问题是,人还不能走开。
Agent 做一步,我们看一下;Agent 遇到问题,我们回答一下;Agent 跑偏了,我们赶紧把它拉回来。
那篇文章把这个过程形容成「照看婴儿」。你看上去没有亲自写多少代码,但注意力始终被占着,根本不敢离开电脑。
Kash 还提到一个「40% 的生产力天花板」。不少开发者用上 Agent 后,生产力提升到一定程度便很难继续增长。
原因不是 Agent 不够快,而是人在同步工作流里成了新的瓶颈。
Agent 再快,也快不过人持续阅读结果、回答问题和做决定的速度。
第三个阶段,才是 Loop。
你不再一轮一轮推动 Agent,而是提前把任务、约束、验证方式和停止条件设计好,让它在后台自己执行。只有遇到真正需要人判断的节点,它才回来找你。
这时,人不需要一直坐在电脑前。
Agent 可以在你吃饭、散步,甚至睡觉的时候继续工作。
睡觉之前,先别急着写代码
以我的实践为例,我现在准备一个长程任务时,不会直接跟 Agent 说「帮我把这个功能做完」。
我会先跟它聊。
要实现的功能是什么?为什么要做?哪些内容属于本次范围?哪些坚决不做?技术上有什么约束?最终达到什么状态才算完成?
这些问题要尽可能在我还坐在电脑前的时候聊清楚。
很多长任务半夜停下来,并不是 Agent 不会写代码,而是它面对某个判断时,不知道该怎么选择
如果前面的产品决策和技术约束没有说清楚,它就只能停下来问你。
而你正在睡觉。。。
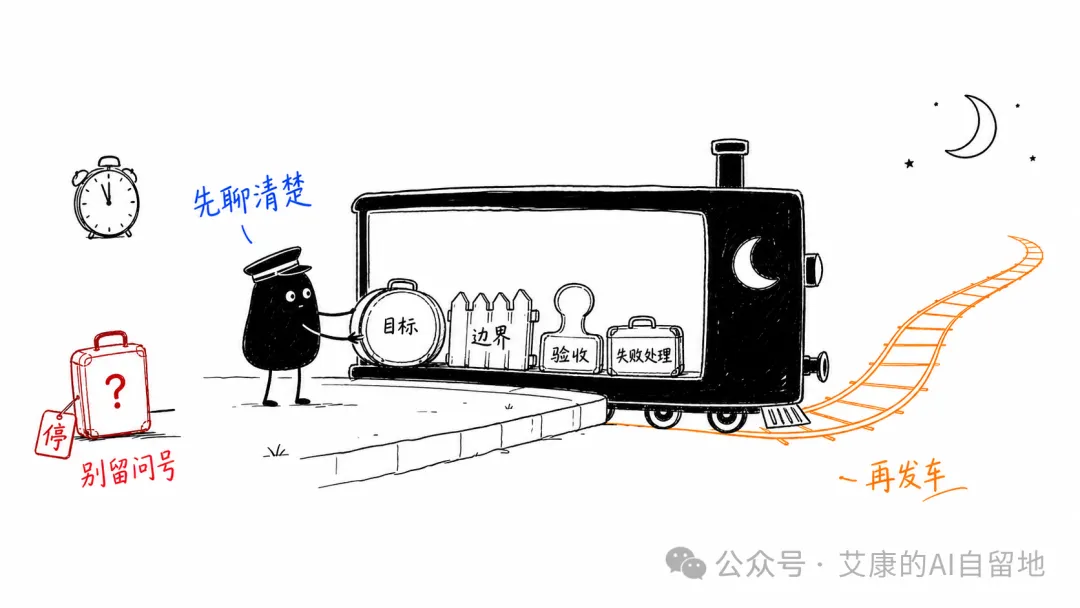
所以我的习惯是先整理出这样一份「睡前交接清单」:
- • 本次任务的目标是什么
- • 哪些内容不在本次范围内
- • 最终的验收标准是什么
- • 遇到普通失败时如何重试或者绕过
- • 完成后需要留下哪些测试、文档和 Commit
甚至可以直接跟 Agent 说:
先不要写代码。根据前面的讨论整理需求、约束、非目标和验收标准,检查还有没有会阻塞后续执行的问题。确认清楚后,再生成一份可以由 SubAgent 独立执行的任务计划。
我在用的 Superpowers 工作流
这一步,我一般会配合 Superpowers 来完成。
Superpowers 是一套给 Agent 使用的软件开发 Skills,是我在编码这个场景下,用得非常多的一个的 Skill。
我喜欢它的一点是:它不会拿到需求就立刻开写。
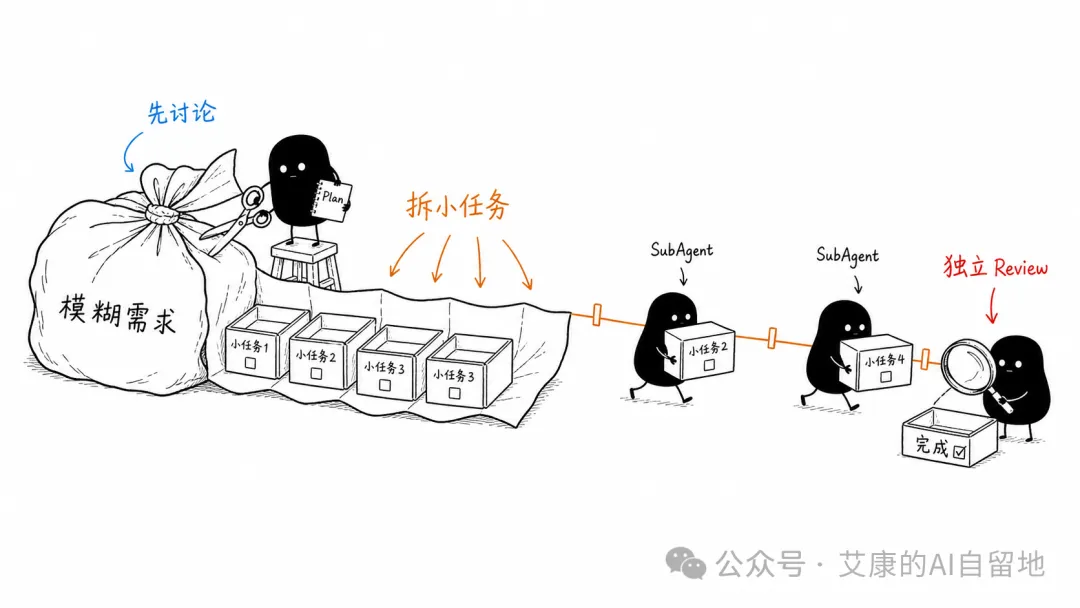
它会先通过 brainstorming 跟我讨论需求,确认设计;再用 writing-plans 把功能拆成一组很小、可以独立验证的任务。
注意,是拆成小任务。
长程任务的「长」,应该来自任务数量多,而不是每一个任务都大到说不清楚。
每一项任务需要修改哪些文件、怎样测试、完成标准是什么,都会提前写进 Plan。
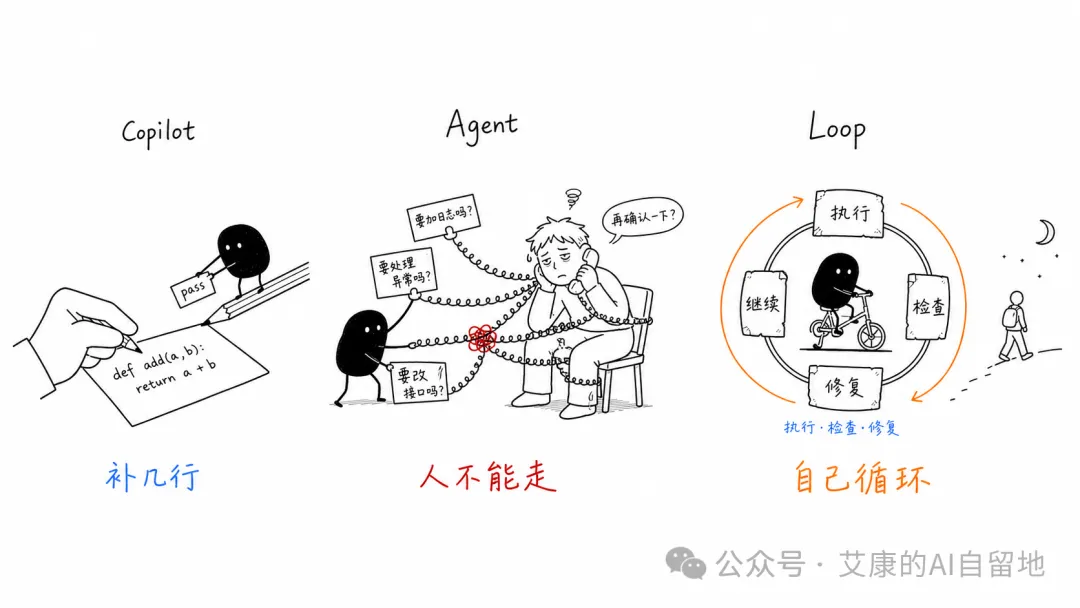
等我确认计划没有问题,再进入 subagent-driven-development:主 Agent 保留完整计划,负责协调和集成;具体编码交给不同的 SubAgent;实现完成后,再派一个新的 SubAgent 检查是否符合需求和代码规范。
整个执行过程大概是这样:
brainstorming → writing-plans → SubAgent 实现 → 独立 SubAgent 做需求与代码审查 → 修复问题 → 集成和测试
给 Agent 一个可以自我判断的反馈信号
计划写得再详细,也只能告诉 Agent「要做什么」。
想让它在我不在场时继续往下走,还需要告诉它:怎么判断自己做对了。
我目前比较看重三件事。
一、采用测试驱动开发,也就是 TDD。
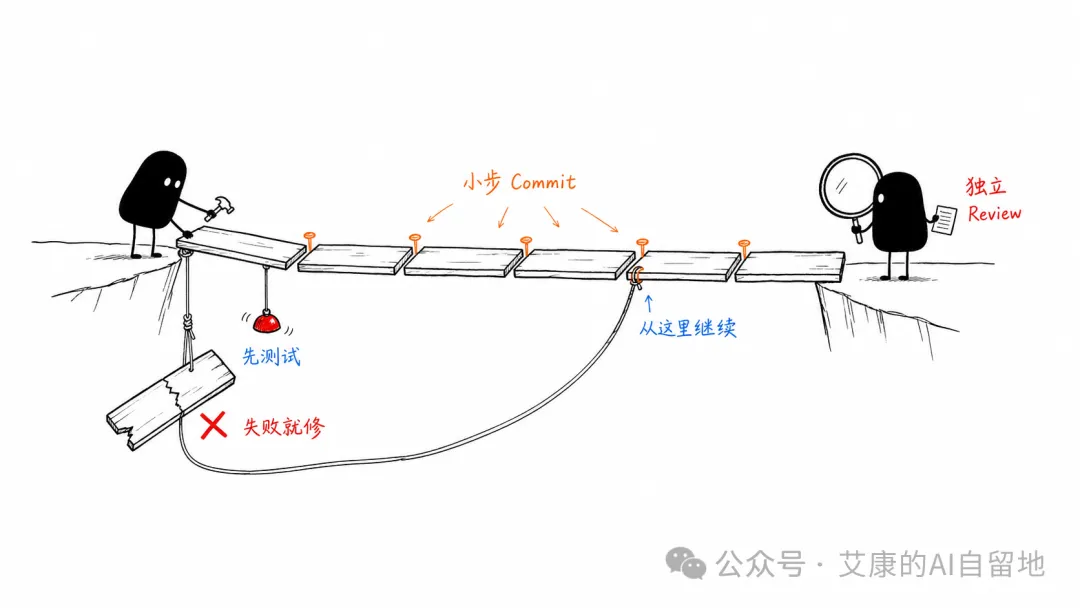
先写一个会失败的测试,确认它确实因为功能尚未实现而失败;再写最少的代码让测试通过;然后进行重构和下一轮测试。
测试给 Agent 提供了一个相对明确的反馈信号。
代码写完不是完成,测试通过才有资格进入下一步。测试失败,它就继续修,而不是回来问我「这样看起来可以吗」。
二、Commit 的粒度要小。
前面那篇硅谷现场记录里还提到一个问题:AI 写代码太快,很容易一次生成一个巨大的 mega PR。
文件改了一大堆,功能混在一起,最后真正耗时间的不是写代码,而是 Review。
所以我的做法是,每完成一个独立、可测试的任务,就提交一次 Commit。
这样不仅方便审查,也相当于给长任务留下一个个进度点。即使中途因为网络、额度或者其他问题停下来,第二天也可以从最近一次提交继续,不需要全部重跑。
这和那篇文章里提到的 durable agent 很像。
长任务真正需要的,不只是持续运行,还要能从失败的位置恢复。
三、让写代码和检查代码的 Agent 分开。
我现在不会太相信 Agent 对自己代码的评价 🤣
因为负责实现的 Agent 已经接受了某种方案,它很容易沿着自己的思路继续证明「这套方案没问题」。
所以在 SubAgent 完成一个任务之后,我会再派一个独立 Agent 做 Review。它不负责替前一个 Agent 解释,而是根据最初的 Plan、测试结果和代码改动找问题。
必要时,我还会直接用 Codex Review 做一次对抗式审查。
一套任务真正的循环就形成了:
读取任务 → 写测试 → 实现代码 → 运行测试 → 修复失败 → 独立审查 → 提交 Commit → 进入下一项任务
不同的工作,交给不同的模型
那场聚会里还有一个观点,我非常认同:不同模型擅长的任务并不一样,搭建 Agent 团队时,也可以以此分配模型职责。
我自己目前常用的一套分工是:
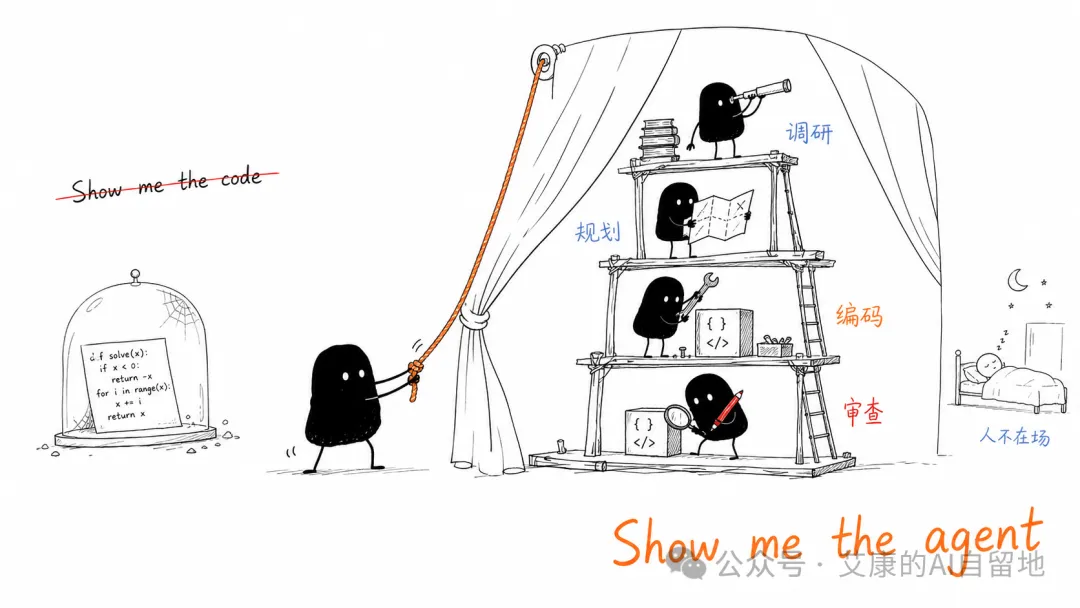
- • 任务规划交给 Fable 5,负责理解需求、判断取舍和设计整体方案
- • 具体编码交给 Opus 5,按照 Plan 完成功能和测试
- • 资料调研交给 Sonnet 5,阅读代码、查找资料、补充上下文
- • 代码审查交给 Codex Review,从另一个模型的视角挑问题
主 Agent 负责记住全局和调度,SubAgent 负责完成边界清楚的任务,独立 Reviewer 负责找错。
每个 Agent 都只需要把自己最擅长的那一部分做好。
早上「收菜」,到底在收什么?
那篇硅谷现场记录里有一个细节:Kash 问现场有多少工程师现在花在 Review 代码上的时间,比亲自写代码更多,台下几乎所有人都举了手。
我自己也有类似的体感。
以前写代码是工作量最大的部分。现在代码可以很快生成,真正需要花心思的,逐渐变成了需求定义、任务拆分、架构判断、测试和 Review。
Agent 并没有让工程工作消失,只是把人的注意力挪到了另外一些地方。
例如在今天早上的那个任务里。
我需要检查的并不只是 Agent 是否已经完成了任务,而是这些更具体的东西:
- • 最终功能是否符合一开始的产品需求
- • 已经实现的功能,是否都可以正常运行
- • 独立 Review 发现了哪些问题并是否已解决
收菜,不等于闭眼合并。人在这个过程中依然要做判断。
写在最后
那篇文章的结尾,我很喜欢。
以前硅谷工程师喜欢说:Show me the code。
但现在,这句话正在慢慢变成:Show me the agent。
大家不再只是聊 AI 能写多少代码、又能多完成一种任务。
因为这些事情已经不需要反复证明了。Claude Code、Codex 能做的事情太多了,代码生成只是其中一部分。
现在更有意思的问题是:你怎样把需求交给它?怎样让它在你不在的时候继续工作?遇到失败之后能不能接着跑?谁来检查它的结果?哪些决定依然要留给人?
这些问题,才决定了 Agent 到底怎么才算落地。